Zum Inhalt springen

Wissen, was Ihre KI wirklich kostet — und was sie bringt.

Plevsy ordnet jeden LLM-Aufruf dem Feature, dem Kunden und dem Ticket zu, für die er lief – in Entwicklung wie in Produktion – und stellt die Kosten daneben, ob das Feature genutzt wird.

Auf die Warteliste

Für alle, die die Frage beantworten müssen — Engineering, Produkt, Finance.

Was das Video zeigt

Das Video hat keinen Ton. Hier seine Bildunterschriften, Szene für Szene – im Video auf Englisch. Die Firma, Nordlicht SaaS GmbH, und alle Zahlen darin sind erfunden.

  1. 0:00Plevsy läuft auf Ihrer eigenen Infrastruktur. Nordlicht SaaS GmbH meldet sich an ihrem Hub an.
  2. 0:08Die Übersicht: was KI in den letzten 14 Tagen gekostet hat, verglichen mit den 14 davor, und an welche Anbieter das Geld ging.
  3. 0:18Jede Ansicht filtert gleich – hier nach den Ausgaben eines Teams.
  4. 0:26Wochenbudgets für Produktion und Entwicklung, gemessen an jedem beliebigen Zeitraum.
  5. 0:34Kosten je Feature: search-assist, ticket-summary und onboarding-copilot.
  6. 0:41Ein Feature: was sein Betrieb kostet, wie oft es genutzt wird und was eine Nutzung an KI kostet.
  7. 0:51Welche Kunden search-assist am meisten nutzen.
  8. 0:57Dieselben Kunden, geordnet danach, was ihre Nutzung des Features an KI gekostet hat.
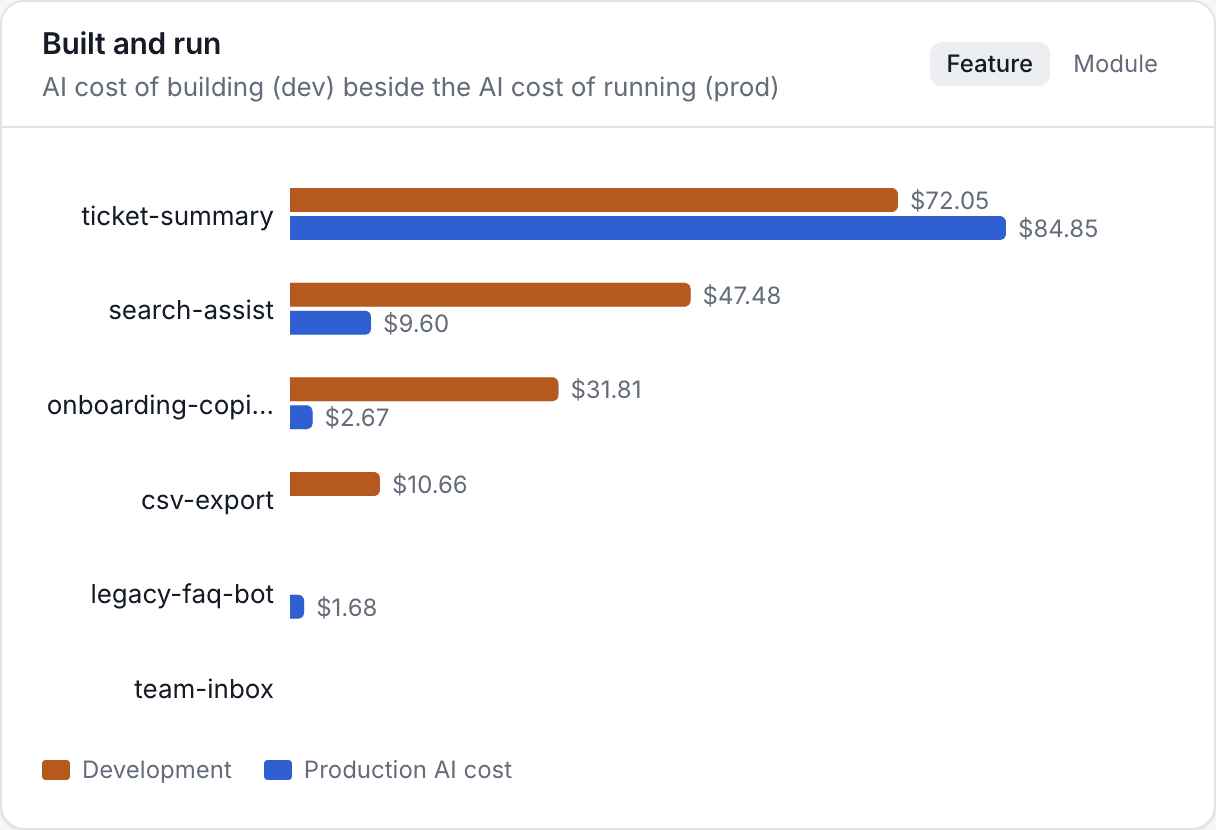
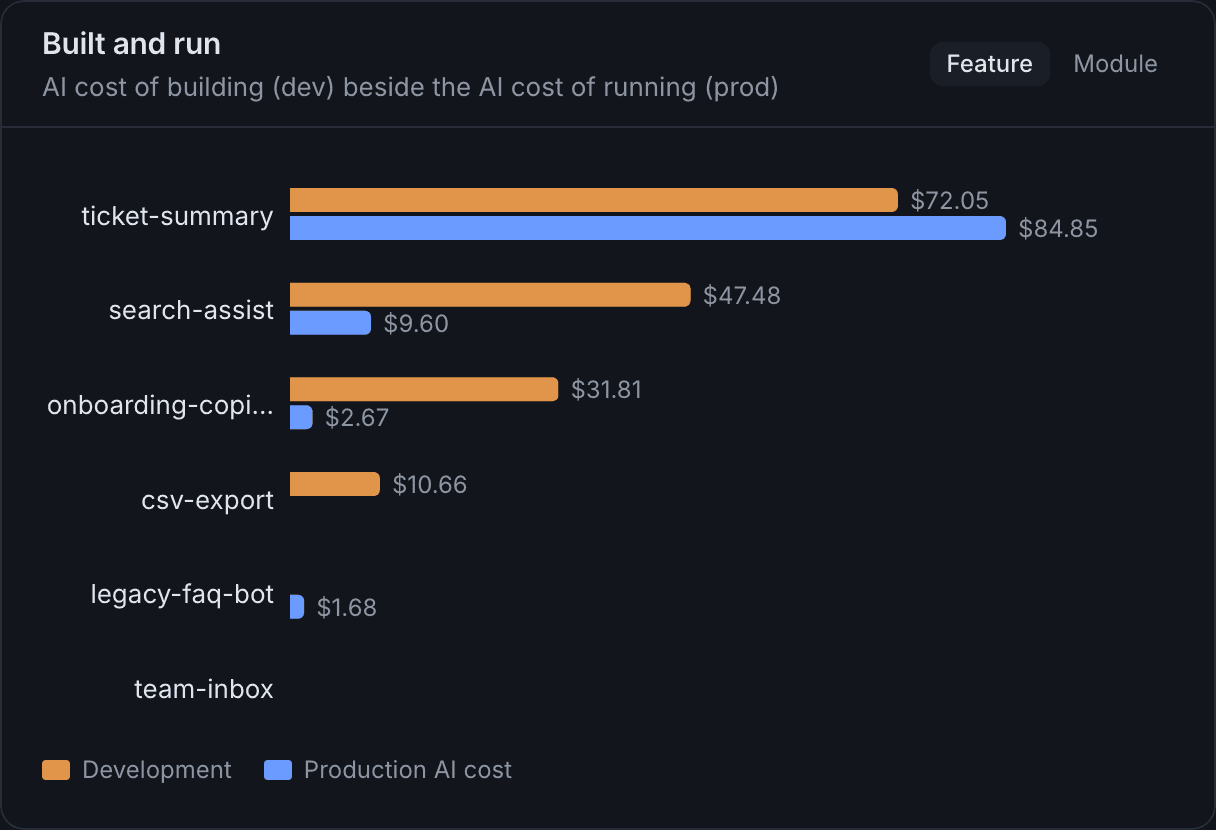
  9. 1:03ROI: was der Bau jedes Features in der Entwicklung gekostet hat, neben dem, was sein Betrieb kostet.
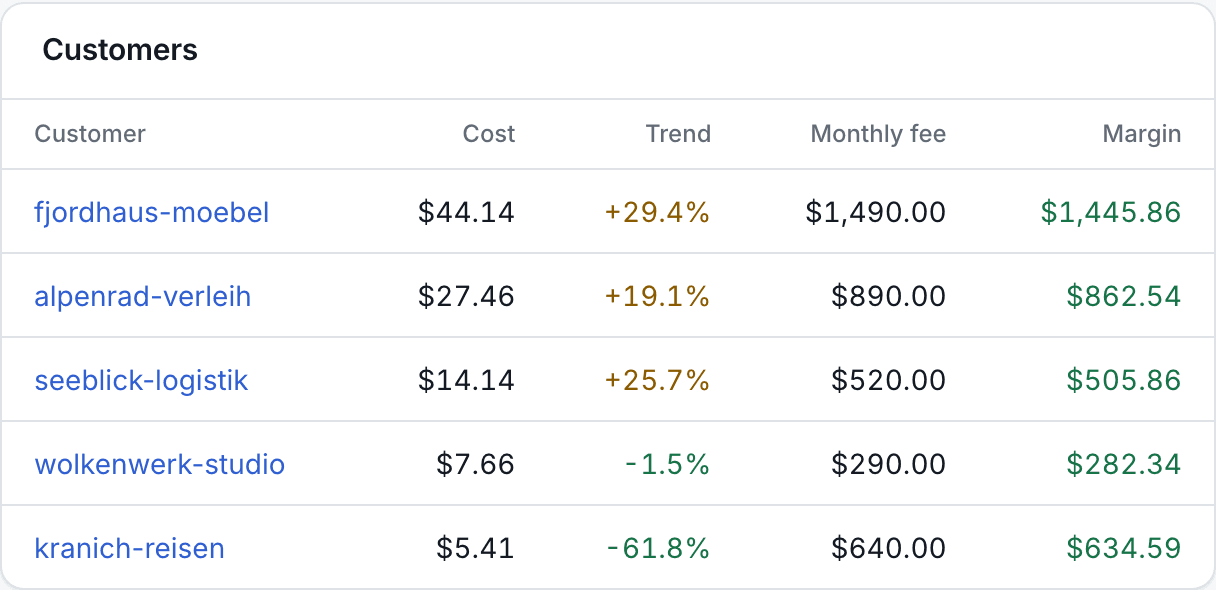
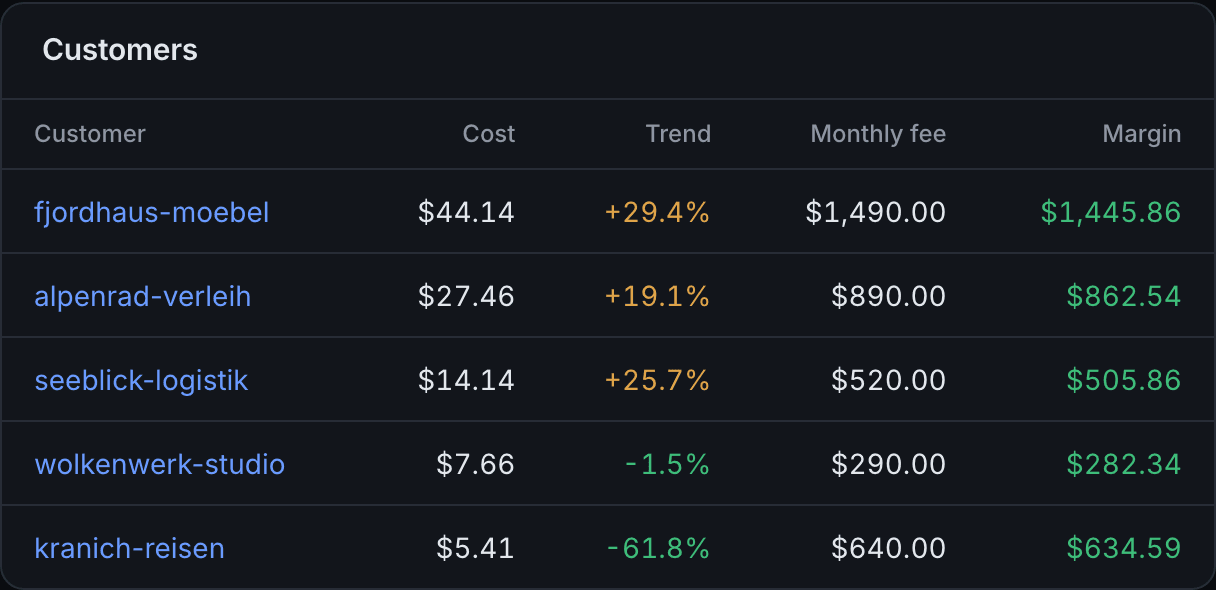
  10. 1:13Kunden: KI-Kosten und Aufrufe je Kunde, neben dem, was jeder zahlt.
  11. 1:23kranich-reisen wurde Mitte des Monats still. Die Ausgaben zeigen das Wochen vor einer Vertragsverlängerung.
  12. 1:29Teams und Entwickler, pseudonymisiert: die Kosten des Bauens, nach Team und nach Tool.
  13. 1:36Investment: was jedes Epic in der Entwicklung gekostet hat, gelesen gegen seine Tickets in Jira.
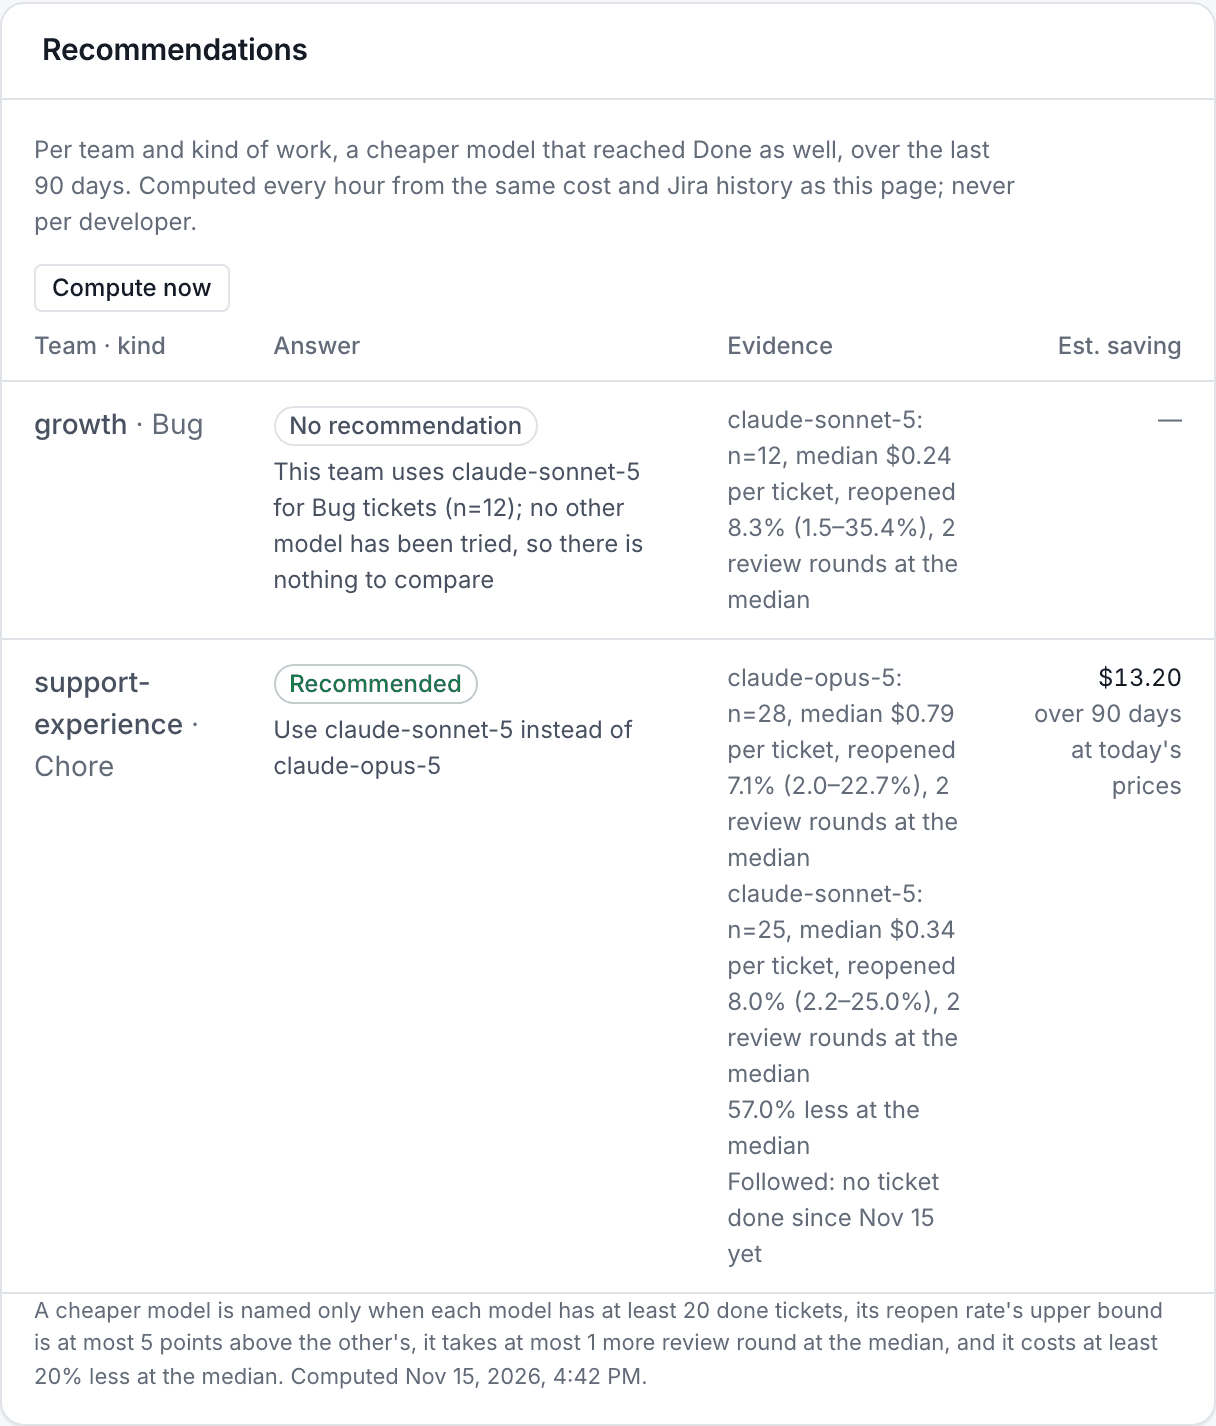
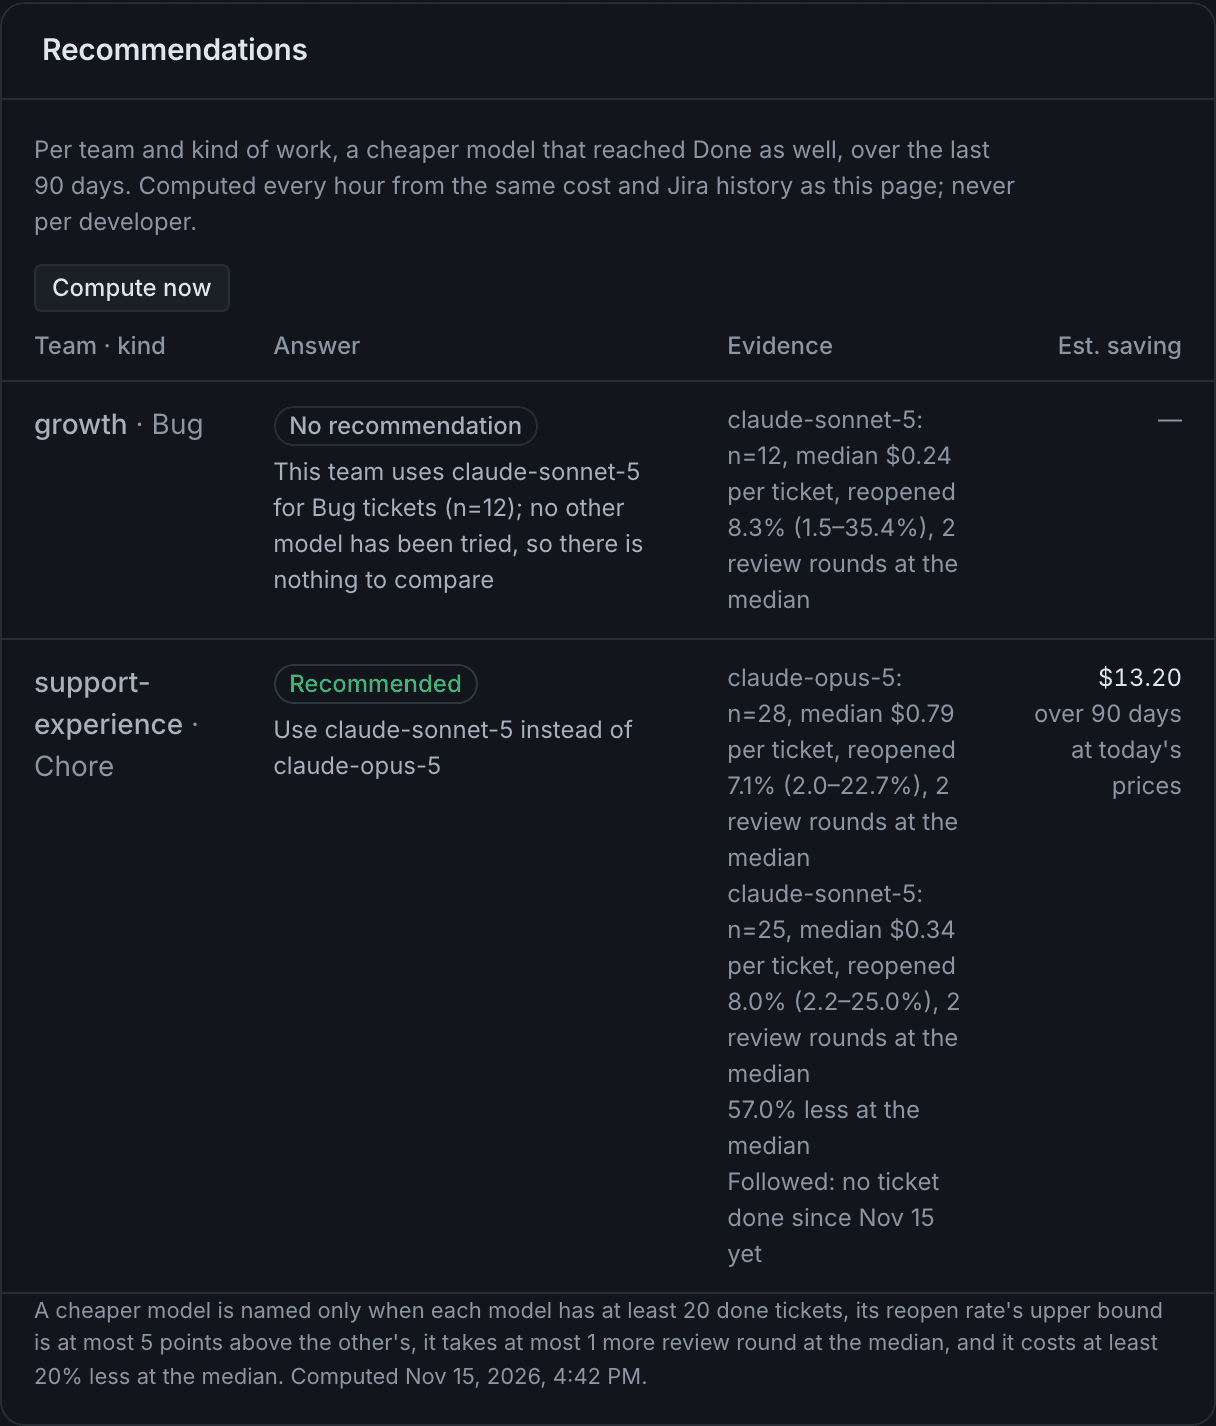
  14. 1:45Empfehlungen: ein günstigeres Modell nur dort, wo es dieselbe Arbeit genauso gut erledigt hat – mit den Belegen.
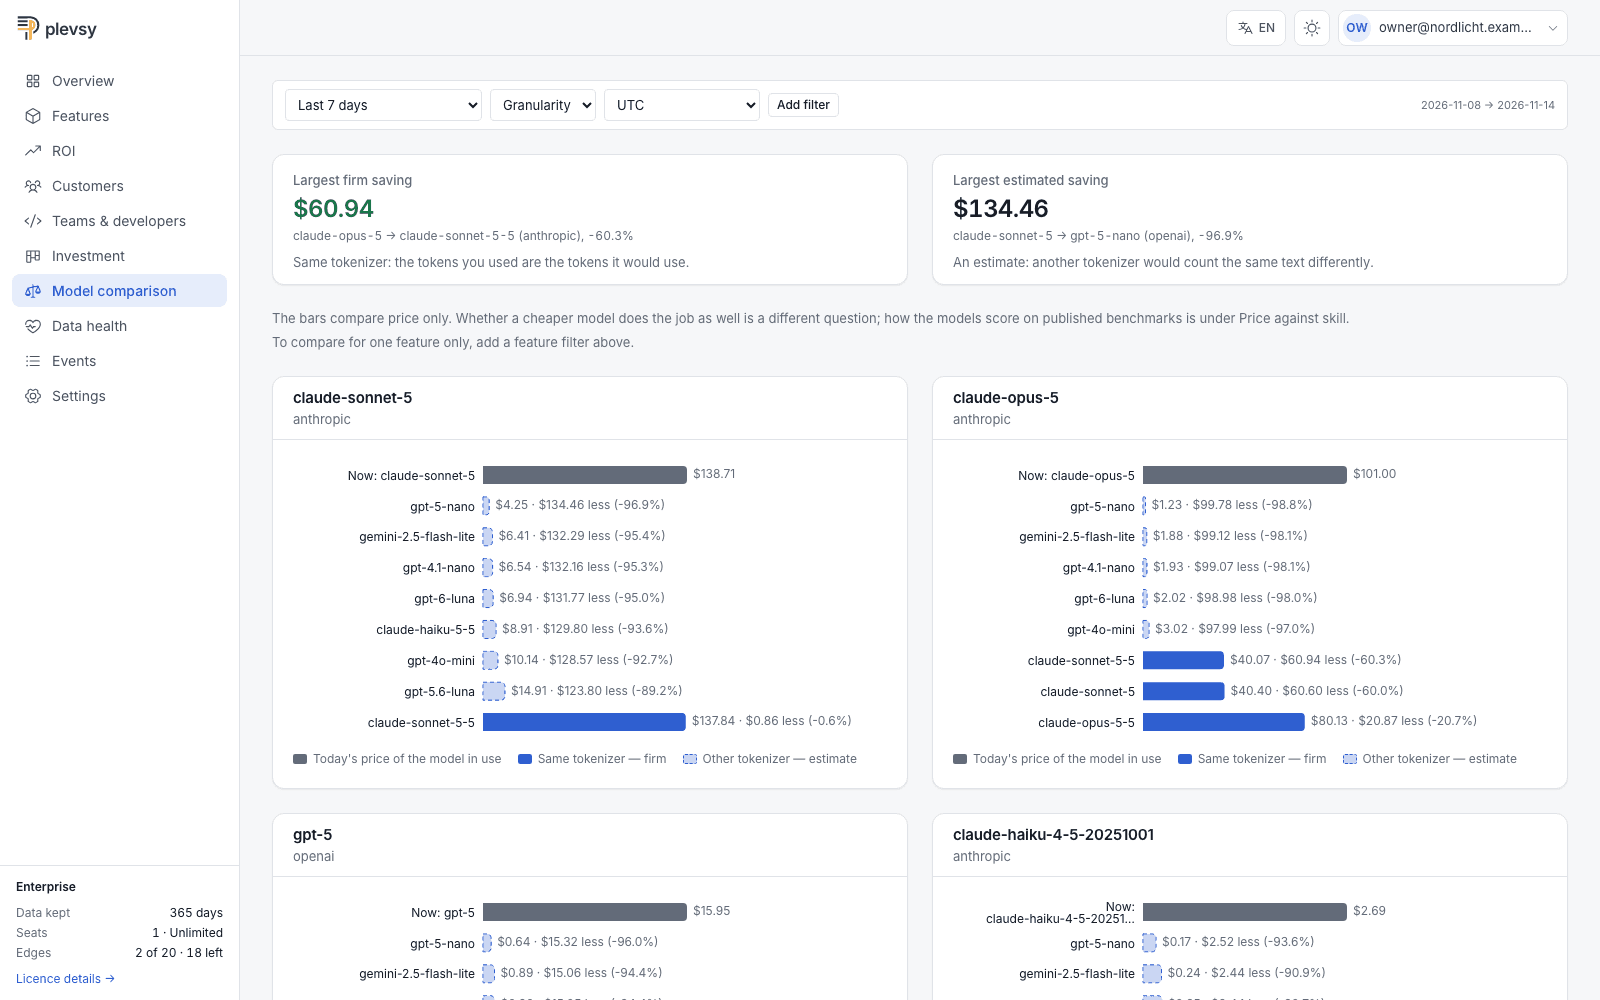
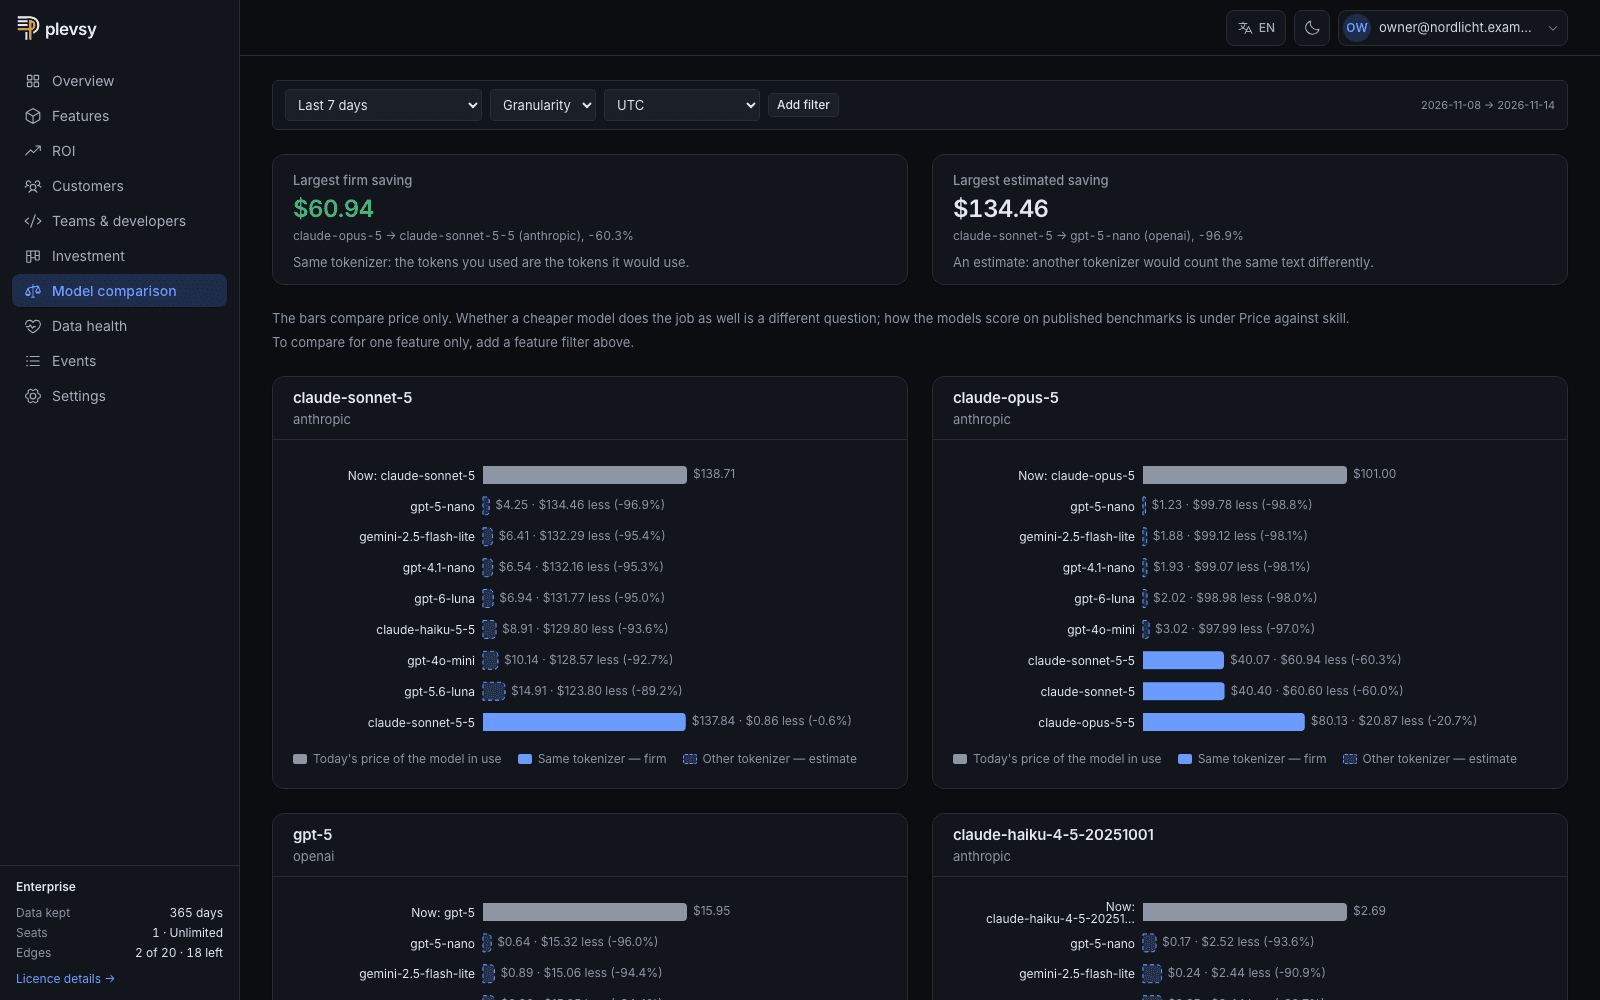
  15. 1:59Modellvergleich: was diese Aufrufe mit einem anderen Modell zu Katalogpreisen gekostet hätten.
  16. 2:09Datenqualität: ob man den Zahlen trauen kann. Abgewiesene Events werden gezählt, nach Grund.
  17. 2:19Jedes Event, wie es gespeichert wurde: Token-Anzahl und Kosten, nie ein Prompt.
  18. 2:25Einstellungen: Personen und ihre Rollen.
  19. 2:29Ingest-Schlüssel, einer pro Umgebung.
  20. 2:32Edges: die Collector für Produktion und Entwicklung – gekoppelt, sie leiten weiter.
  21. 2:36Single Sign-on über Ihren Identity Provider.
  22. 2:40Preise aus einem signierten Katalog, mit Ihren eigenen Preisen und Rabatten.
  23. 2:43Zuordnung: Ein Wert, legacy-faq-bot, gehört noch zu keinem Feature. Ihn zuzuordnen ist ein Schritt.
  24. 2:52Die Lizenz, an diesen Hub gebunden, und der Heartbeat: nur Zählwerte, nur gesendet, wenn eingeschaltet.
  25. 3:00Wie lange Events aufbewahrt werden.
  26. 3:04Jede Änderung, im Audit-Log.
  27. 3:07Wie Entwickler erscheinen: hier pseudonymisiert, nach Wahl des Mandanten.
  28. 3:11Der Mandant selbst.
  29. 3:14Wie Datum und Zahlen dargestellt werden, für jede Person.
  30. 3:18Auf Englisch und Deutsch, hell und dunkel.
  31. 3:28Das Kundenportal: Hier verwaltet Nordlicht seine Lizenz und seine Hubs.
  32. 3:36Die Events dieses Monats, von den Hubs mit Heartbeat, gemessen am Kontingent der Lizenz.
  33. 3:43Die Angaben zur Organisation.
  34. 3:47Mitglieder und ihre Rollen, jedes per E-Mail eingeladen.
  35. 3:51Hubs: online oder offline registriert, jeder mit seiner Version und seinem letzten Heartbeat.
  36. 4:01Jede ausgestellte Lizenz und die gültige, offline prüfbar.

Die Rechnung Ihres Anbieters ist eine einzige Zahl.

Ihre Entwickler wissen, welches Modell sie aufgerufen haben; niemand weiß, für welches Feature oder welchen Kunden.

Wenn Finance fragt, was die KI-Ausgaben gebracht haben, ist die ehrliche Antwort heute eine Tabelle und eine Schätzung.

So funktioniert es

Fünf Schritte, vom Aufruf in Ihrem Code bis zu Kosten auf einem Feature – und als Modellempfehlung zurück zu den Coding-Tools Ihrer Entwickler.

  1. Jeden Aufruf melden

    In der Produktion meldet Ihr Code Token-Anzahl, Modell, Feature und Kunde – per HTTP aus jeder Sprache oder über das TypeScript-SDK. Auf den Rechnern der Entwickler erfasst plevsy-dev jeden Aufruf aus Claude Code und Codex CLI exakt und liest das Ticket aus dem Branch-Namen. Events mit Prompt- oder Completion-Feldern werden abgewiesen.

  2. Dort sammeln, wo die Daten sind

    Betreiben Sie eine Edge in Ihrem Entwicklungsnetz und eine in der Produktion. Edges puffern lokal und leiten an einen Hub weiter, nur ausgehend. Oder senden Sie direkt an den Hub.

  3. Bepreisen

    Die Preise stammen aus einem signierten Katalog mit Tarifen für Input, Output, Cache und Batch. Verlangt ein Anbieter oberhalb einer Prompt-Länge mehr, gilt für den Aufruf der Tarif seiner Länge; lässt die Seite des Anbieters die Regel offen, wird der Eintrag markiert statt geraten. Ihre verhandelten Preise und Rabatte haben Vorrang.

  4. Zuordnen

    Ordnen Sie Repositories, Ticket-IDs und Kunden-IDs Features, Teams und Kunden zu. Ist Jira Cloud verbunden, bringt jedes Ticket sein Epic, seinen Vorgangstyp und seinen Status mit. Events werden nie umgeschrieben: Eine Umbenennung – oder ein Ticket, das in ein anderes Epic wandert – gilt für die gesamte Historie.

  5. Ein günstigeres Modell empfehlen

    Aus denselben Kosten und demselben Jira-Verlauf ermittelt der Hub für jedes Team und jede Art von Arbeit, ob ein günstigeres Modell die Arbeit genauso gut erledigt hat, und nennt es – oder sagt, dass es keine Empfehlung gibt, und warum. Die Entwicklungs-Edge hält eine Kopie, und ein Coding-Tool fragt sie, welches Modell es für die anstehende Arbeit verwenden soll. Es ist ein Rat: Ein Team nimmt ihn an oder nicht.

Was es beantwortet

Was hat es gekostet, Feature X mit KI zu bauen?

Jeder Aufruf aus einem Coding-Tool trägt Entwickler, Ticket und Tool. Tickets sind Features zugeordnet und über Jira ihren Epics und Initiativen, also lesen sich die Entwicklungskosten nach Initiative, Epic und Ticket – und nach Team und Tool.

Entwickler erscheinen standardmäßig pseudonymisiert, und Ansichten nach Entwickler brauchen eine eigene Berechtigung.
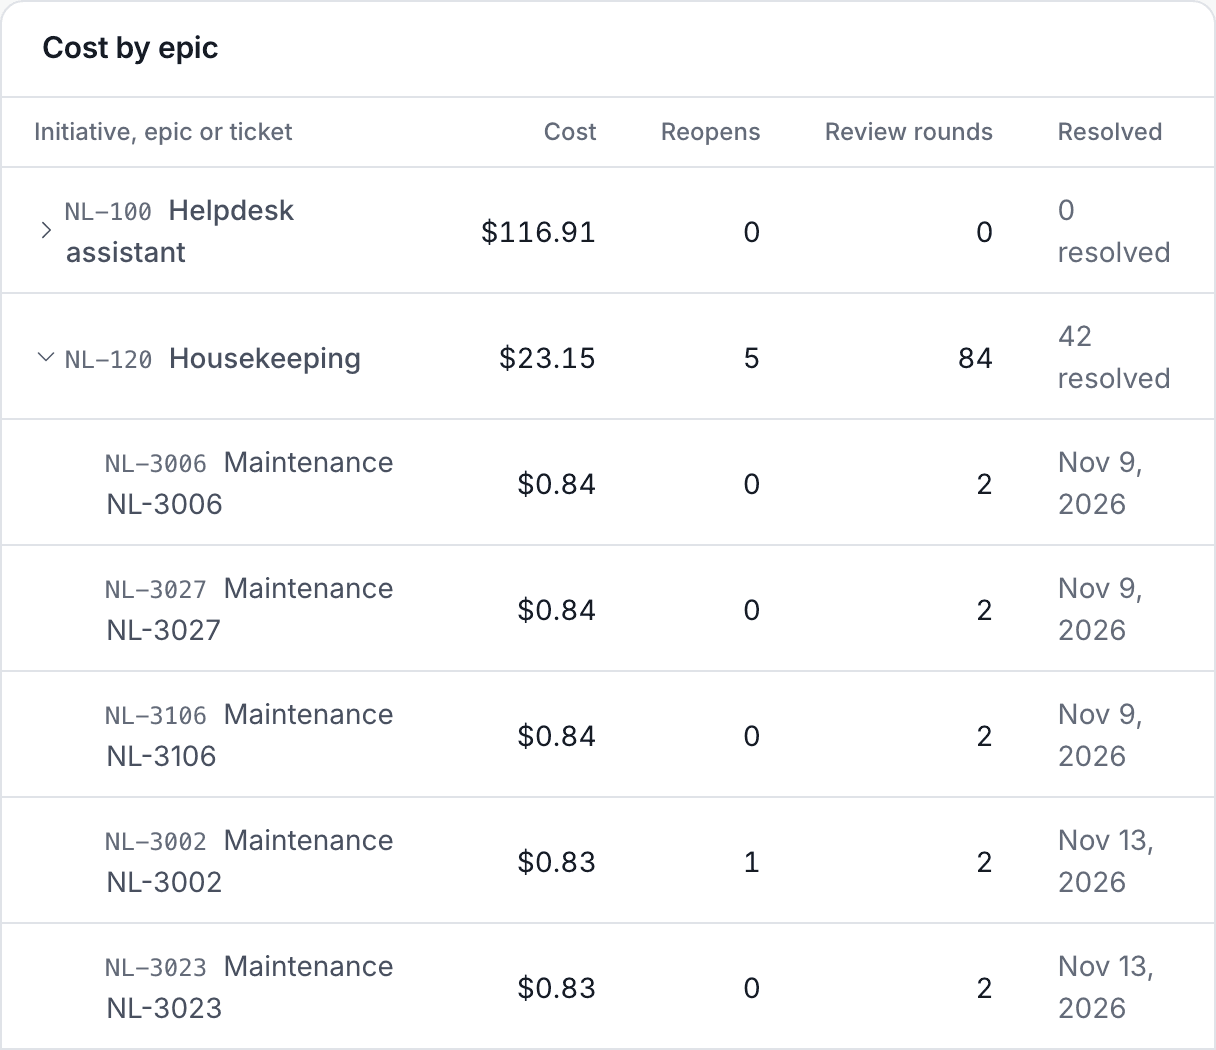
Die Ansicht Investment: KI-Entwicklungskosten nach Epic und Ticket, mit dem, was laut Jira daraus wurde – Wiedereröffnungen, Review-Runden und erledigte Tickets.

Was kostet Feature X im Betrieb, und für wen?

KI-Kosten in der Produktion nach Feature, Modul, Kunde und Modell.

Kosten pro Nutzung, nicht nur pro Aufruf: gemittelt über die Nutzungen, die ein Feature meldet, und exakt für Aufrufe, die eine Trace-ID verbindet. Pro Kunde die Marge gegenüber der monatlichen Gebühr, die Sie hinterlegen.

Die Ansicht Kunden: Kosten jedes Kunden, ihr Verlauf, die Monatsgebühr und die Marge.

Wird das, was wir gebaut haben, auch genutzt?

Ihr Code meldet Nutzungen — Events ohne KI darin, etwa „Zahlung abgeschlossen“, 312-mal.

Die Entwicklungskosten jedes Features stehen neben seinen Nutzungen, als Entwicklungskosten pro 1.000 Nutzungen. Releases als Markierungen in den Diagrammen: geplant.

Die ROI-Ansicht: Entwicklungskosten und KI-Kosten in der Produktion nebeneinander für jedes Feature.

Täte es ein günstigeres Modell?

Plevsy bepreist die tatsächlich verbrauchten Tokens neu auf den 72 aktuellen Modellen von Anthropic, OpenAI und Google in seinem signierten Katalog, mit veröffentlichten Benchmark-Werten neben dem Preis, wo es welche gibt. Wo sich der Tokenizer unterscheidet, ist der Wert als Schätzung markiert.

Die Ansicht Modellvergleich: für jedes genutzte Modell, was dieselben Tokens auf günstigeren Modellen kosten würden, fest oder geschätzt.

Und hat es die Arbeit genauso gut gemacht?

Der Preis allein ist keine Antwort. Für jedes Team und jede Art von Arbeit – Bug, Chore, Feature, Spike – liest Plevsy die Jira-Tickets der letzten 90 Tage. Ein günstigeres Modell nennt es nur, wenn jedes Modell mindestens 20 erledigte Tickets hat, die des günstigeren nicht öfter wieder geöffnet werden (auf fünf Prozentpunkte) und höchstens eine Review-Runde mehr brauchen, und es pro Ticket mindestens 20 % weniger kostet.

Dann nennt es das Modell, die Ersparnis und jede Zahl dahinter. Andernfalls sagt es „keine Empfehlung“ und warum; bei weniger als 20 Tickets zeigt es, wie viele es hat. Es ist ein Rat, den ein Team annimmt oder nicht: Plevsy leitet keinen Aufruf um, wechselt kein Modell und nennt keinen Entwickler.

In Claude Code, und in Cursor, wo es eingerichtet ist, kommt die Antwort von der Edge in Ihrem eigenen Netz – auch wenn der Hub nicht erreichbar ist, dann als veraltet markiert. Dieselbe Empfehlung lässt sich als Änderung an CLAUDE.md oder AGENTS.md des Repositorys vorschlagen, als Diff, den jemand prüft. Beides ist optional. Das Tool antwortet nur; die Entscheidung trifft der Entwickler oder sein Agent.

Die Karte Empfehlungen: die Empfehlung eines günstigeren Modells für ein Team, mit Belegen und geschätzter Ersparnis, und für ein anderes „keine Empfehlung“ mit dem Grund.

Budgets und Datenqualität

Wöchentliche Budgets pro Umgebung

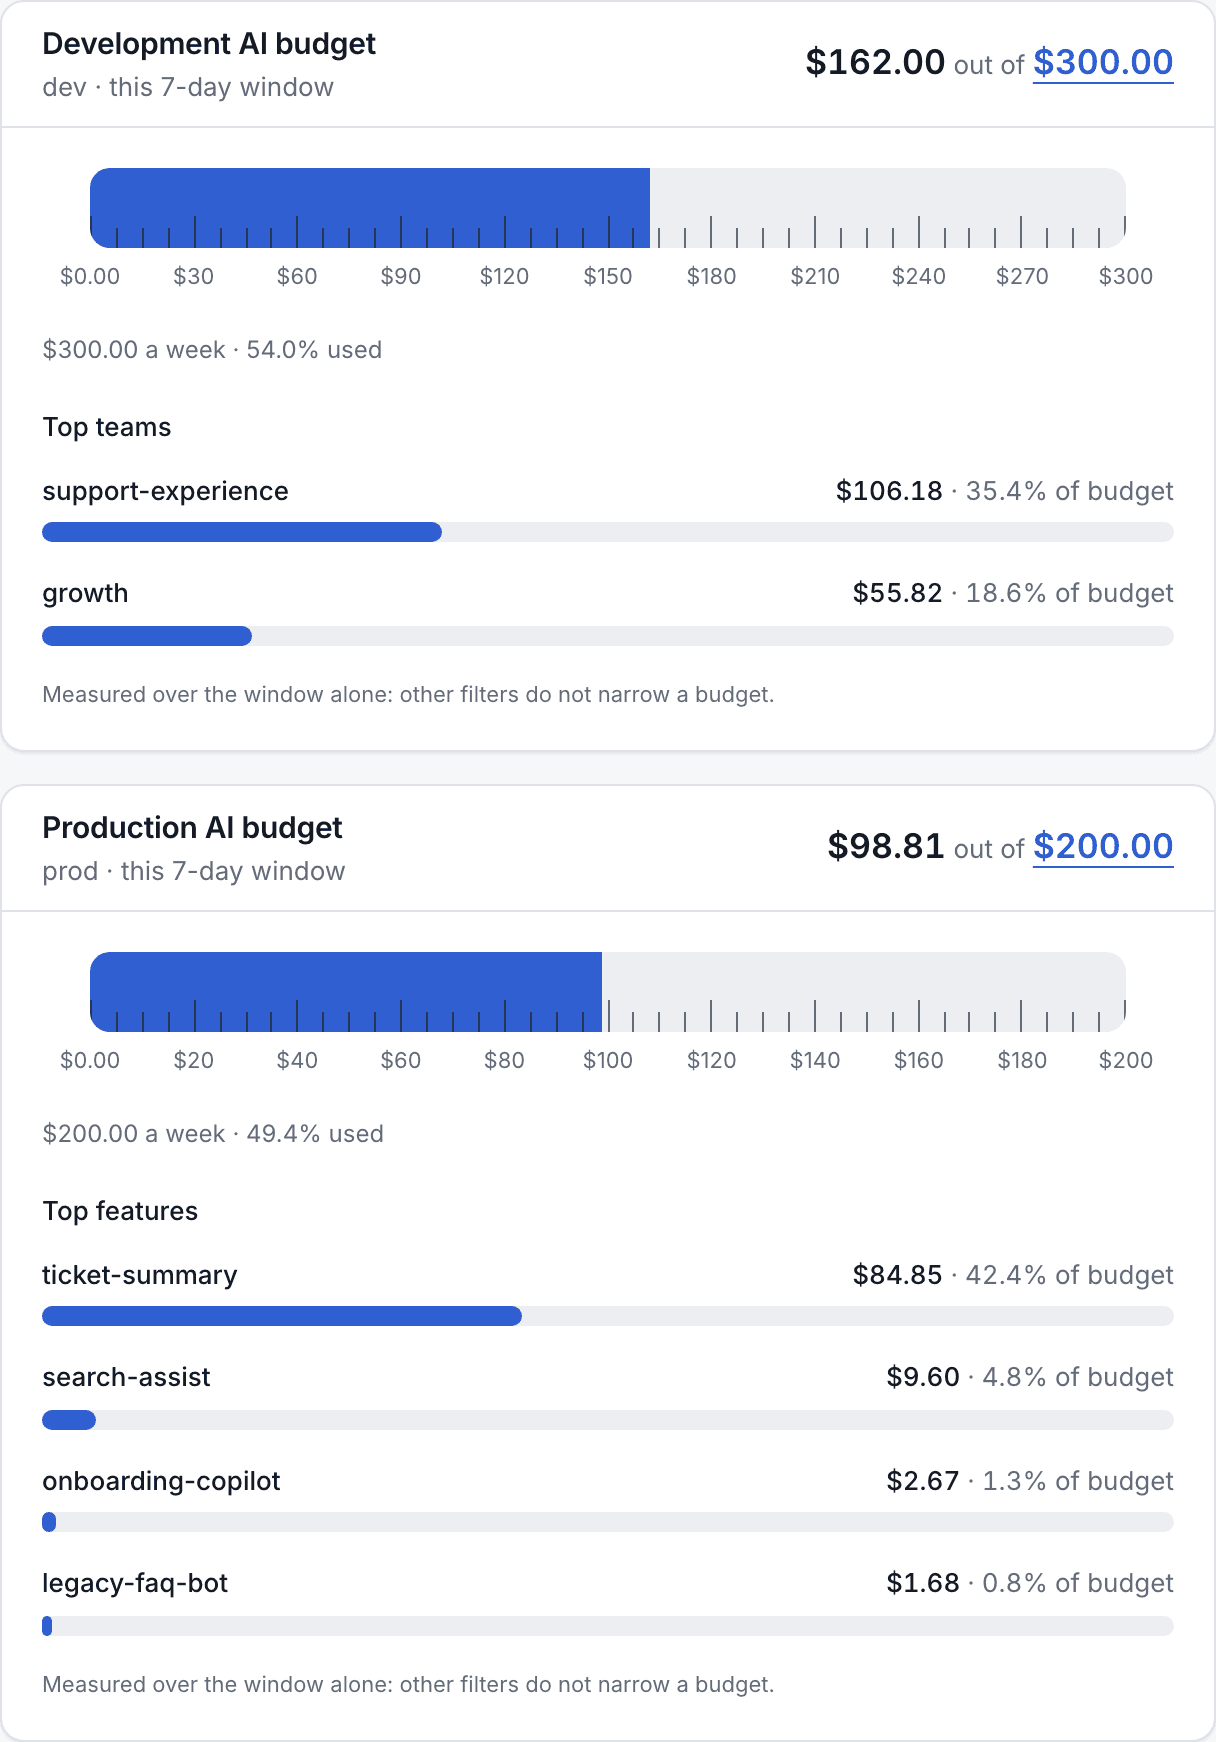
Legen Sie ein wöchentliches KI-Budget für die Entwicklung und eines für die Produktion fest. Jeder Zeitraum, den Sie ansehen, wird am darauf skalierten Budget gemessen.

KI-Budgets für Entwicklung und Produktion dieser Woche, mit den größten Teams und Features.

Nichts versteckt

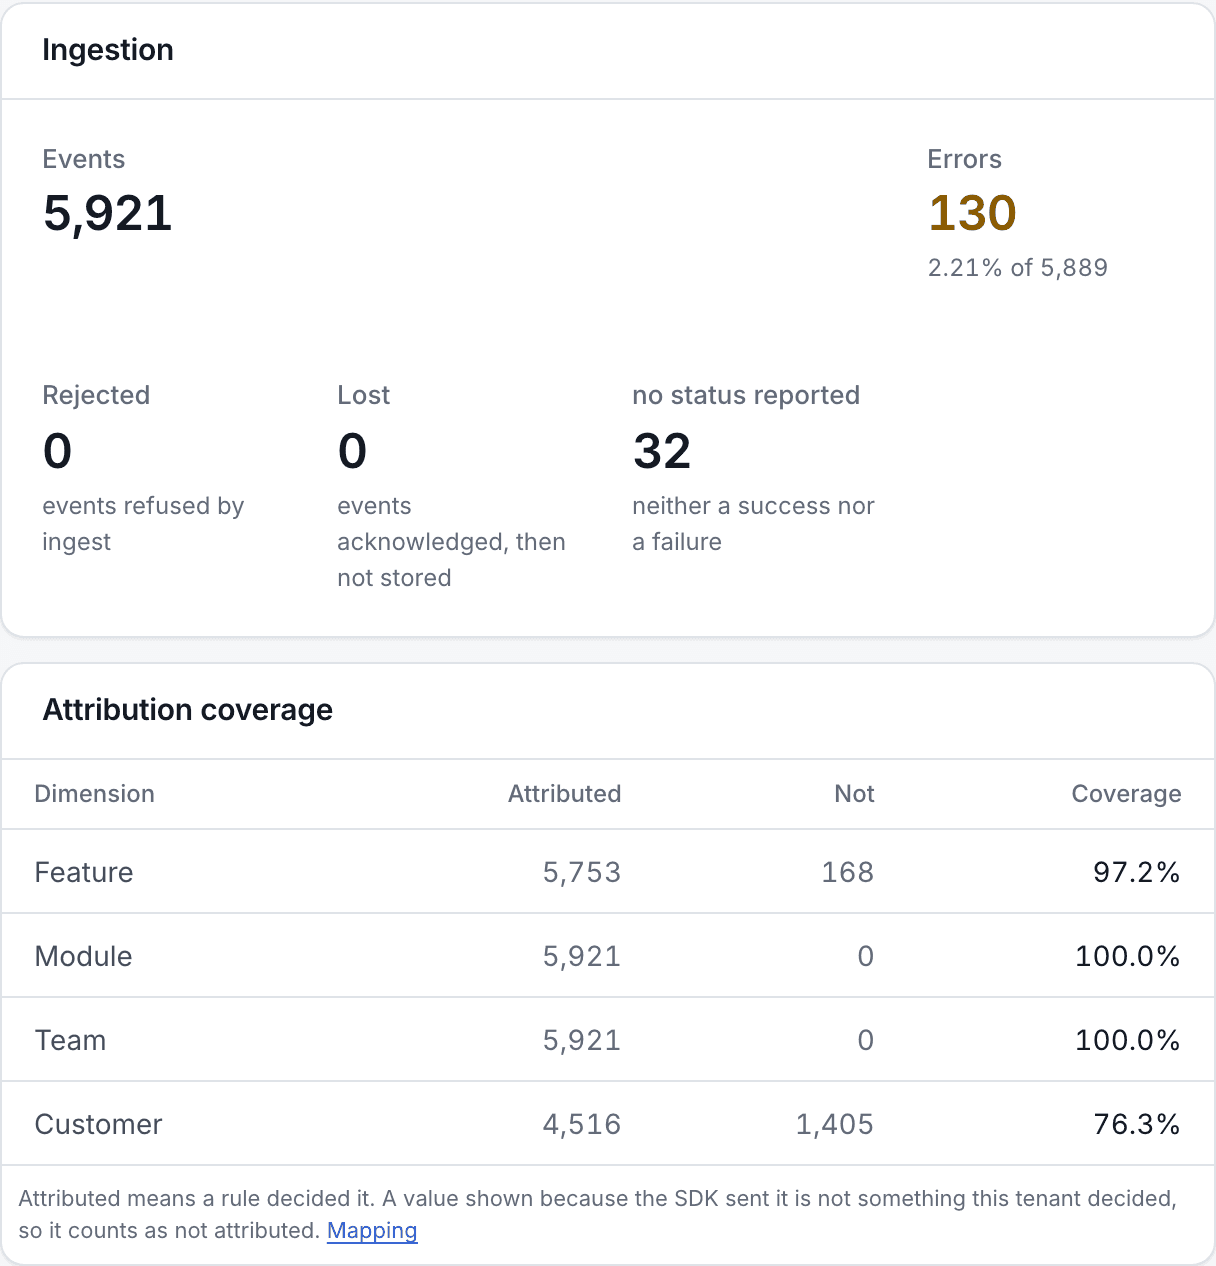
Nicht zugeordnete Werte, Modelle ohne Preis und abgewiesene Events werden aufgelistet, jeweils mit Grund. Ein Aufruf ohne Preis zählt ohne Kosten, nie als null – und sobald ein Preis existiert, bepreist eine Neuberechnung die vergangenen Aufrufe, nachdem sie genau gesagt hat, wie viele es betrifft.

Die Ansicht Datenqualität: Ingestion mit abgewiesenen und verlorenen Events, und die Zuordnungsabdeckung je Dimension.

Gebaut für europäische Unternehmen

Nur Metadaten

Tokens, Modell, Kosten und Tags. Prompt- und Completion-Felder werden bei der Annahme abgewiesen, in jeder Tiefe; das Event-Schema hat keinen Platz für sie. Tag-Werte sind Freitext, also halten Sie Inhalte daraus fern.

Auf Ihrer Infrastruktur

Ein Binary, gebaut als Docker-Image, mit Postgres und ClickHouse. Docker-Compose-Dateien liegen bei.

Nach außen verbindet es sich nur für Preise und für seine Lizenz, und beides lässt sich abschalten: Laden Sie den signierten Katalog aus einer Datei und installieren Sie die Lizenzdatei von Hand. Ihre eigene Jira-Site liest es, sobald Sie sie verbinden; einen Heartbeat, nur mit Zählwerten, sendet es, wenn Sie ihn einschalten, und einen Problembericht, wenn jemand einen sendet.

Finance sieht Kosten, keine Personen

Daten auf Ebene einzelner Entwickler liegen hinter einer eigenen Berechtigung. Die Finance-Rolle sieht Kosten, Kunden, ROI und Budgets und kann Budgets festlegen — aber keine Entwickler, Teams, Repositories oder Tickets, durchgesetzt von der API, nicht nur ausgeblendet.

Ihre Kunden-IDs bleiben Ihre

Kunden-IDs bleiben auf Ihrem Hub und erhalten ihre Namen aus Ihrem eigenen Verzeichnis. Mit einer Lizenz kann eine Edge sie vor dem Weiterleiten durch einen schlüsselbasierten Hash ersetzen.

Jede Änderung protokolliert

Eine Änderung und ihr Audit-Eintrag werden gemeinsam geschrieben: Lässt sich der Eintrag nicht schreiben, unterbleibt die Änderung. Auch Anmeldungen, abgewiesene Anmeldungen und beendete Sitzungen werden festgehalten. Anmeldungen bleiben 180 Tage gespeichert, Änderungen 730 – beides in Grenzen einstellbar, nie unbegrenzt.

Integrationen

Heute

  • Events-API per HTTP unter POST /v1/events, aus jeder Sprache. Nimmt Aufrufe an Anthropic, OpenAI, Google, Azure OpenAI, AWS Bedrock und Mistral an.
  • Ein TypeScript-SDK, @plevsy/sdk, das jeden Aufruf und jede Nutzung eines Features meldet.
  • plevsy-dev auf den Rechnern der Entwickler: Claude Code und Codex CLI, exakt pro Aufruf, das Ticket aus dem Branch.
  • plevsy-dev mcp und advise: die Modellempfehlung jedes Teams dort, wo gearbeitet wird – das MCP-Tool model_policy für Claude Code und Cursor (optional), und die Tabelle „Model policy“ in CLAUDE.md oder AGENTS.md, als Diff vorgeschlagen.
  • Jira Cloud: Epic, Vorgangstyp, Status und Workflow-Verlauf jedes Tickets, stündlich abgeglichen.
  • Preise für Modelle von Anthropic, OpenAI und Google. Aufrufe an andere Anbieter werden gespeichert und gezählt, ohne Preis.
  • Eine in OpenAPI beschriebene Lese-API für Ihr eigenes BI-Tool: Zeitreihen, Aufschlüsselungen, Kunden, Traces, Modellvergleich, Datenqualität.
  • Single Sign-on mit OIDC.

Noch ist nichts veröffentlicht: Hub, Edge, SDK und plevsy-dev gibt es ab dem ersten Release zum Herunterladen.

Geplant

  • Das Python-SDK.
  • Gemini CLI; Cursor und Copilot als Summen je Schlüssel, wenn danach gefragt wird.
  • Jira-Fix-Versionen als Releases, und Jira Data Center.
  • Stripe, für Umsatz pro Kunde.
  • Gehostet in der EU.

Stufen

Noch keine Preise: Bezahltes verkaufen wir erst, wenn wir es können. Die bezahlten Stufen kommen bald, und Sie können Ihr Interesse an einer unten anmelden.

  • Free

    Zum Ausprobieren: eine Woche Verlauf.

    Enthält

    • Jedes Event wird angenommen
    • 7 Tage Verlauf
    • 3 Edges
    • 3 Plätze
    • 1 Hub
    • Jede Woche die neuesten Preise

    Herunterladen und betreiben

  • Enterprise

    Bald verfügbar

    Ein Jahr Verlauf für eine Installation im Betrieb.

    Enthält

    • Jedes Event wird angenommen
    • 365 Tage Verlauf
    • 20 Edges
    • Unbegrenzt viele Plätze
    • Preise aus dem Standard-Feed
  • Enterprise Unlimited

    Bald verfügbar

    Keine Grenze für Verlauf, Edges oder Plätze.

    Enthält

    • Jedes Event wird angenommen
    • Unbegrenzter Verlauf
    • Unbegrenzt viele Edges
    • Unbegrenzt viele Plätze
    • Preise aus dem Priority-Feed

Interesse an einer bezahlten Stufe anmelden

Wir schreiben Ihnen einmal, sobald die gewählte Stufe verfügbar ist. Kein Konto, keine Bestätigungs-E-Mail.

Freiwillig. Was wir wissen sollten, etwa wie viele Hubs Sie betreiben würden.

Ihre E-Mail-Adresse, die Stufe und Ihre Notiz speichern wir, bis Sie uns um Löschung bitten. Ihre IP-Adresse und Ihren Browser speichern wir nur als Hash, mit einem geheimen Schlüssel gebildet, und löschen ihn nach 30 Tagen. Datenschutzerklärung.

Auf die Warteliste.

Wir senden Ihnen einen Link, um Ihre Adresse zu bestätigen. Anmeldungen, die nicht innerhalb von 7 Tagen bestätigt werden, löschen wir.

Wo soll es laufen?

Der Rest ist freiwillig

Es sagt uns, was wir als Nächstes bauen. Überspringen Sie, was Sie lieber nicht beantworten.

Anbieter, die Sie nutzen

Wir nutzen Ihre Antworten, um das Produkt zu planen und Ihnen E-Mails zu Plevsy zu senden. Für nichts anderes. Jede E-Mail enthält einen Link, mit dem Sie sich von der Liste entfernen. Datenschutzerklärung.

Fragen

Wie gehen Sie mit DSGVO und Datenresidenz um?

Selbst gehostet bleiben die Daten dort, wo Sie Plevsy betreiben. Events enthalten keine Prompt-Inhalte, und eine Edge kann Kunden-IDs vor dem Weiterleiten hashen.

Die Aufbewahrungsdauer legt jeder Mandant fest. Das Audit-Log hält jede Änderung und jede Anmeldung fest, und seine Einträge verfallen je nach Art. Die Daten einer einzelnen Person auf Anfrage zu löschen, ist noch nicht gebaut.

Wie viel Latenz fügt das SDK einer Anfrage hinzu?

Einen Aufruf zu erfassen dauert unter 200 ns, ein Client mit dem Wrapper des SDK braucht etwa eine Mikrosekunde mehr – im eigenen Benchmark des TypeScript-SDK. Das Event entsteht erst, nachdem die Antwort Ihren Code erreicht hat, und wird im Hintergrund gesendet; eine Edge in Ihrem Netz puffert, sodass Ihr Code nie auf den Hub wartet.